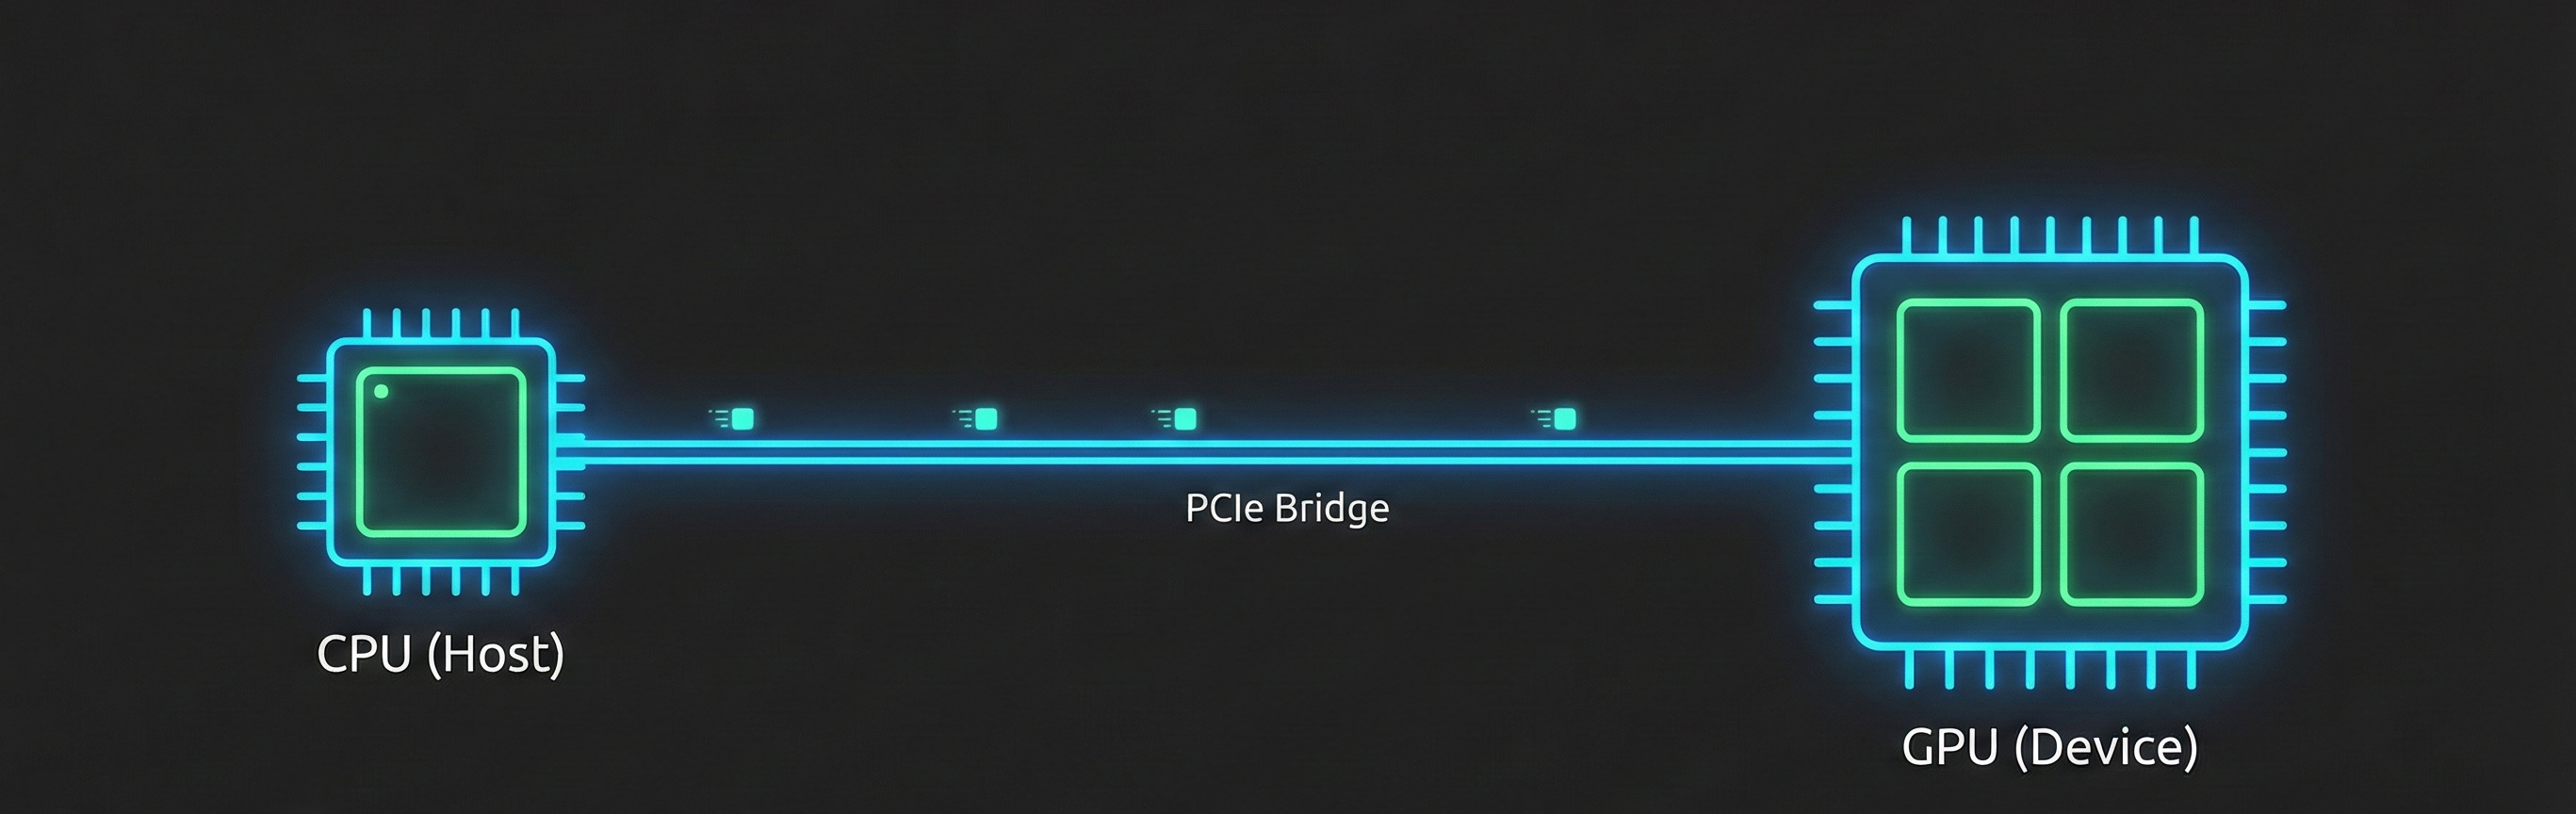
From scalar loops to SIMD vectorization and CUDA grids, blocks, and warps: why CPUs minimize latency while GPUs maximize throughput, how H2D/D2H data movement dominates runtime, and how to fight back with divergence-free kernels and tuned PyTorch DataLoaders.
Hardware-Aware Programming for Dummies!